Bloqueio de IA na Cloudflare: como decidir entre proteger conteúdo e ampliar a visibilidade em SEO e GEO
 Felipe Bazon
Tabela de conteúdo
- 1. TL;DR
- 2. Neste artigo, você vai entender:
- 3. O que mudou na Cloudflare?
- 4. Como ficam as configurações existentes?
- 5. Quais configurações são recomendadas para novos domínios?
- 6. Google-Extended não é Googlebot
- 7. AI Overviews e AI Mode possuem outro controle
- 8. As regras mudam entre plataformas
- 9. Permitir no painel não garante acesso
- 10. O Daily Mail mostra por que bloquear e negociar podem coexistir
- 11. Outros publishers britânicos escolheram acordos de participação
- 12. Minha posição: eu partiria da abertura aos bots
- 13. Por que isso importa para SEO, GEO e Organic Visibility?
- 14. Ferramentas de GEO ajudam a avaliar os efeitos dessa escolha
- 15. O que eu revisaria agora?
- 16. Fatos, interpretação, inferência e hipótese
- 17. Conclusão
- 18. Referências e créditos
Novas opções de rastreamento ampliam a discussão sobre proteção de conteúdo, treinamento de modelos e visibilidade nas IAs. As decisões dos publishers britânicos ajudam a entender o que está em jogo.
A Cloudflare anunciou, em 15 de setembro de 2026, o Disallow AI Training, uma opção para recusar treinamento de IA preservando o acesso de determinados crawlers à busca. Anúncio de Bryan Becker, da Cloudflare.
Minha posição parte de uma preferência: para conteúdo público, eu tenderia a deixar os bots de IA livres para acessar o site. Vejo valor estratégico em permitir que informações sobre uma marca, seus especialistas e seu conhecimento circulem pelos sistemas que participam da descoberta e da decisão das pessoas.
Grandes portais, porém, precisam avaliar essa escolha a partir do modelo de negócio. Publicidade, assinaturas, licenciamento e construção de audiência própria mudam o valor atribuído a cada forma de acesso.
Os casos do Daily Mail, do Financial Times e do Guardian mostram que essa discussão envolve muito mais do que uma configuração técnica.
TL;DR
- Rastreamento, treinamento e participação em respostas generativas possuem controles distintos.
- Google-Extended e Googlebot cumprem funções diferentes.
- O histórico do Daily Mail combina bloqueio de determinados bots com abertura a parcerias comerciais.
- Financial Times e Guardian também estabeleceram acordos com empresas de IA.
- Minha preferência é permitir o acesso ao conteúdo público, considerando as particularidades do negócio.
- A hipótese de que participar do treinamento favoreça o reconhecimento da marca precisa ser separada de qualquer promessa de citação.
- Entity SEO, Topical Authority, Information Gain e monitoramento ajudam a transformar essa decisão em uma estratégia de visibilidade.
Neste artigo, você vai entender:
- o que mudou nos controles da Cloudflare;
- como interpretar a migração das configurações existentes;
- quais diferenças existem entre acesso, treinamento e respostas de IA;
- o que os publishers britânicos ensinam sobre bloqueio e negociação;
- por que eu partiria da abertura aos bots;
- como SEO e GEO contribuem para a compreensão e a descoberta de uma marca;
- quais indicadores acompanhar depois de definir uma política de acesso.
O que mudou na Cloudflare?
As opções Block e Block on pages with ads passam a alcançar crawlers de uso misto, incluindo Googlebot, Bingbot e Applebot. As configurações existentes serão migradas. Detalhes da mudança.
Antes de alterar qualquer opção, eu separaria três perguntas: quem precisa acessar o site, para qual finalidade e com quais consequências para o negócio?
O Bot Preference Sync organiza preferências por finalidade e as sincroniza com o robots.txt.
| Controle | Finalidade | Decisão da empresa |
|---|---|---|
| Search | Rastreamento para construir e atualizar um índice de busca | Permitir que o mecanismo encontre as páginas |
| Training | Coleta para treinamento ou ajuste de modelos | Autorizar ou restringir esse uso |
| Agent | Acesso realizado por uma ferramenta a pedido de uma pessoa | Permitir que o agente consulte o conteúdo |
Fonte: Cloudflare, Bot Preference Sync. Explicações em português, com os nomes dos controles preservados.
Essa separação ajuda a documentar a intenção. A implementação ainda depende dos mecanismos oferecidos e respeitados por cada fornecedor.
Como ficam as configurações existentes?
Tabela 1. Migração do controle antigo “Block AI”.
| Configuração anterior de “Block AI” | Search | Training | Agent |
|---|---|---|---|
| Disabled (unselected) | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
Fonte: Cloudflare, Bryan Becker, 15/09/2026. Nomenclatura original preservada.
Tabela 2. Migração dos controles separados.
| Controle | Configuração anterior | Nova configuração |
|---|---|---|
| Search | Allow | Allow |
| Search | Block | Block |
| Search | Block on pages with ads | Block on pages with ads |
| Training | Allow | Allow |
| Training | Block | Disallow AI Training |
| Training | Block on pages with ads | Disallow AI Training |
| Agent | Allow | Allow |
| Agent | Block | Block |
| Agent | Block on pages with ads | Block on pages with ads |
Fonte: Cloudflare. Nomenclatura original preservada.
Quais configurações são recomendadas para novos domínios?
Tabela 3. Recomendações conforme a monetização do site.
| Configuração | Sem monetização por anúncios | Com monetização por anúncios |
|---|---|---|
| Preference Sync | Enabled | Enabled |
| Search | Allow | Allow |
| Training | Allow | Disallow AI Training |
| Agent | Allow | Block on pages with ads |
Fonte: Cloudflare. Nomenclatura original preservada.
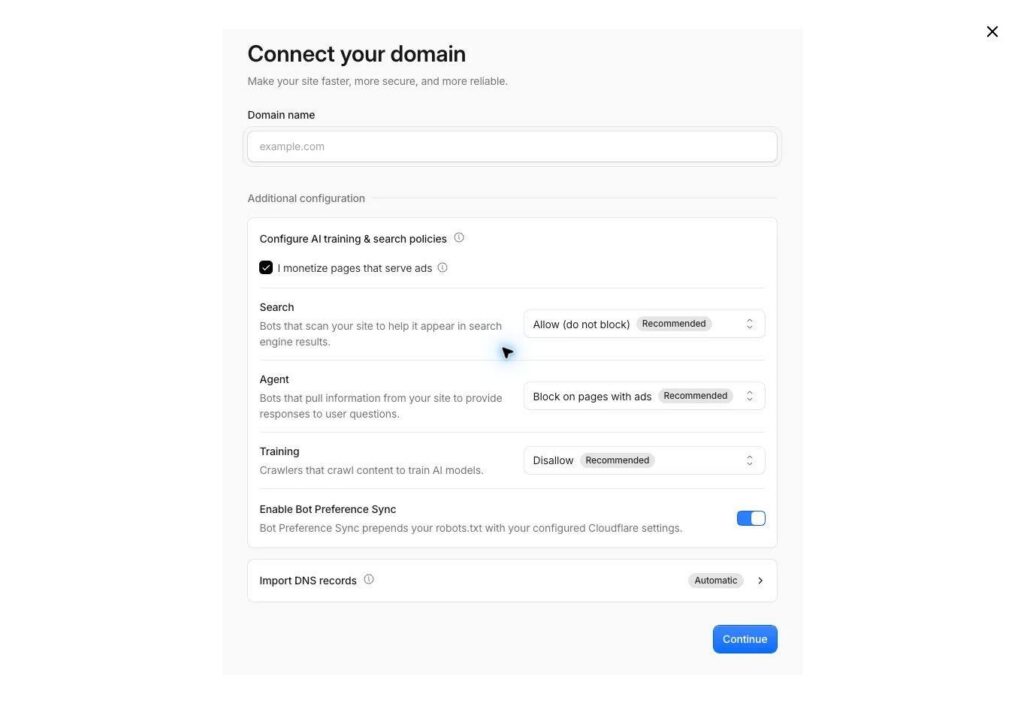
Figura 1. Cadastro de domínio monetizado por anúncios. Crédito: Cloudflare, imagem publicada no artigo de Bryan Becker, em 15/09/2026.
Minha leitura é que essas recomendações devem iniciar a discussão entre audiência, tecnologia e direção comercial. Para um portal, eu avaliaria quais oportunidades de distribuição e negociação justificam aceitar ou modificar cada opção. A configuração sugerida pelo fornecedor precisa ser confrontada com a estratégia do veículo.
Google-Extended não é Googlebot
O Google-Extended é um identificador de controle no robots.txt. Ele não possui uma identificação HTTP própria de crawler.
Segundo o Google, esse controle abrange o uso de conteúdo para treinamento de futuras gerações dos modelos Gemini e para fundamentar respostas em determinados produtos, incluindo Gemini Apps e Grounding with Google Search no Vertex AI.
A documentação também informa que o Google-Extended não afeta a inclusão no Google Search nem funciona como sinal de ranqueamento. Documentação oficial sobre Google-Extended.
Portanto, preservar a busca tradicional e preservar todas as experiências generativas são objetivos diferentes. Uma recomendação de bloqueio precisa identificar exatamente quais produtos e usos serão afetados.
AI Overviews e AI Mode possuem outro controle
O Search Console disponibiliza um controle específico para participação nos recursos generativos da Busca.
Ele abrange AI Overviews, AI Mode e funcionalidades generativas do Discover. A exclusão impede a utilização de conteúdo e links da propriedade nessas experiências, sem funcionar como sinal de inclusão ou ranqueamento nas demais partes da Busca.
Esse controle não regula treinamento de modelos. Documentação do controle de IA generativa na Busca.
Antes de solicitar uma alteração à equipe técnica, a empresa precisa definir sua intenção: restringir treinamento, deixar de participar de respostas generativas ou impedir o acesso de determinado crawler.
Uma instrução genérica para “bloquear as IAs” deixa decisões importantes implícitas.
As regras mudam entre plataformas
A orientação publicada pela Microsoft em setembro de 2023 descreve o uso de NOARCHIVE para restringir treinamento e participação nas respostas do então Bing Chat, preservando a presença na busca tradicional. A combinação com NOCACHE recebe tratamento diferente, portanto os controles precisam ser avaliados em conjunto. Orientação de Fabrice Canel, do Bing.
Na OpenAI, GPTBot e OAI-SearchBot também possuem funções distintas. O primeiro está associado ao treinamento; o segundo, à busca. A documentação permite configurar os dois de forma independente. Documentação dos bots da OpenAI.
Essa distinção explica por que bloquear treinamento não implica, necessariamente, abrir mão da descoberta em uma experiência de IA.
Eu verificaria os controles diretamente na documentação de cada plataforma antes de replicar uma configuração. Nomes parecidos e objetivos semelhantes não garantem o mesmo comportamento.
Permitir no painel não garante acesso
A política também precisa ser conferida nas regras de segurança.
A Cloudflare explica que regras do WAF podem bloquear crawlers permitidos no AI Crawl Control. Dependendo de onde o bloqueio ocorre, a interferência pode não aparecer nas análises desse produto. Documentação sobre AI Crawl Control e WAF.
Por isso, uma captura de tela com a opção Allow não encerra uma auditoria.
Eu verificaria a resposta efetivamente entregue ao crawler, os eventos de segurança e as regras aplicadas às páginas relevantes. A configuração registrada precisa corresponder ao comportamento do site.
O Daily Mail mostra por que bloquear e negociar podem coexistir
O histórico do Daily Mail acrescenta uma camada importante à discussão.
Em outubro de 2023, o veículo já aparecia entre os publishers que bloqueavam o GPTBot, segundo levantamento de Charlotte Tobitt para o Press Gazette. Esse registro comprova uma restrição específica naquela data. Não sustenta a afirmação de que o jornal bloqueou todo acesso de qualquer IA desde o início.
Em setembro de 2024, Rich Caccappolo, da DMG Media, explicou que o grupo bloqueava conscientemente agentes de treinamento, mas admitiu que melhores condições de atribuição poderiam abrir espaço para liberar conteúdo. A declaração foi registrada por Adam Tinworth na cobertura do Future of Media Technology Conference.
Dois meses depois, a própria DMG Media anunciou investimento e parceria com a ProRata. O acordo envolvia acesso a conteúdo em uma proposta de busca generativa com atribuição e remuneração associada ao uso. Anúncio oficial da DMG Media, de 20 de novembro de 2024.
Em setembro de 2026, a cobertura de Gretel Kahn para o Reuters Institute voltou a mostrar o Daily Mail discutindo experimentação com buscas de IA, proteção da propriedade intelectual e valorização do jornalismo original. Isso indica uma estratégia em avaliação, sem comprovar a retirada de todos os bloqueios. Relato do Reuters Institute, publicado em 11 de setembro.
Minha leitura é que o grupo procurou preservar poder de negociação enquanto explorava formas de participação. Bloquear um agente e licenciar conteúdo para outro serviço podem fazer parte da mesma estratégia.
Outros publishers britânicos escolheram acordos de participação
O Financial Times anunciou, em abril de 2024, uma parceria com a OpenAI que incluía conteúdo atribuído no ChatGPT, links e colaboração em produtos. O acordo também previa uso de conteúdo para melhorar os modelos. Anúncio da parceria com o Financial Times.
O Guardian anunciou parceria com a OpenAI em fevereiro de 2025, com jornalismo atribuído no ChatGPT. Comunicado oficial.
Esses casos mostram possibilidades diferentes de participação. Um publisher pode restringir coleta indiscriminada e negociar acesso, atribuição e remuneração. Outro pode priorizar distribuição mais ampla para fortalecer reconhecimento e descoberta.
Os acordos também não demonstram que liberar qualquer bot produz os mesmos benefícios. Eles envolvem condições comerciais específicas, que precisam ser consideradas antes de comparar resultados.
Minha posição: eu partiria da abertura aos bots
Como orientação geral, eu deixaria os bots de IA livres para acessar o conteúdo público.
Minha hipótese é que participar dos materiais utilizados pelos modelos pode ampliar as oportunidades de associação entre uma marca, seus especialistas e os assuntos sobre os quais ela possui conhecimento. Quando essas associações são consistentes e sustentadas por conteúdo de qualidade, vejo potencial para favorecer reconhecimento e futuras menções.
É uma hipótese estratégica. As fontes discutidas aqui não comprovam uma relação causal entre liberar treinamento e receber mais citações.
Existem etapas diferentes nesse caminho. Permitir acesso não garante coleta. A coleta não comprova inclusão em treinamento. Participar do treinamento não assegura que o modelo reconhecerá a marca como autoridade. E uma resposta pode citar uma página recuperada durante a busca, independentemente de ela ter participado do treinamento.
Ainda assim, minha preferência pela abertura permanece. Para empresas que dependem de descoberta e construção de marca, considero relevante participar dos ambientes em que as pessoas procuram informação e formam suas referências.
Nos grandes portais, essa preferência precisa ser confrontada com o modelo de negócio. Conteúdo exclusivo, assinaturas, custos de produção e oportunidades de licenciamento podem justificar políticas diferentes por fornecedor ou por conjunto de páginas.
Por que isso importa para SEO, GEO e Organic Visibility?
Em uma estratégia de SEO para portais de notícias, o acesso influencia a descoberta e a atualização das páginas. Um bloqueio indevido durante uma cobertura relevante pode limitar a distribuição de uma reportagem antes mesmo de sua qualidade ser considerada.
Para Generative Engine Optimization, essa discussão inclui a possibilidade de recuperação do conteúdo, a compreensão da marca e sua participação nas respostas.
A abertura técnica oferece uma condição de acesso. O trabalho editorial e reputacional precisa dar motivos para que aquela fonte seja escolhida.
É aqui que Entity SEO, Topical Authority e Information Gain ajudam a aprofundar a estratégia.
Entity SEO: tornar clara a identidade da fonte
O trabalho de Entity SEO ajuda a organizar quem é o veículo, quem são seus autores e quais relações existem entre essas entidades e os temas publicados.
Biografias consistentes, identificação editorial, páginas institucionais, referências externas e dados estruturados coerentes reduzem ambiguidades. Minha preocupação seria garantir que a especialização percebida corresponda à atuação real do portal.
Liberar um bot para acessar um conjunto de páginas sem autoria clara ou identidade consistente resolve apenas uma parte do problema.
Topical Authority: sustentar especialização ao longo do tempo
A Topical Authority exige continuidade, profundidade e coerência na cobertura.
Para um portal de notícias, eu observaria a capacidade de acompanhar um assunto antes, durante e depois do pico de interesse. Reportagens originais, fontes identificadas, contexto histórico e atualizações úteis ajudam a construir uma referência editorial naquele campo.
Essa é a conexão com News Topical Authority: demonstrar especialização por meio da cobertura, sem reduzir autoridade a volume de publicações ou a uma pontuação universal.
Information Gain: oferecer algo que outras fontes não entregam
O Information Gain aparece quando o conteúdo acrescenta informação útil àquilo que já está disponível.
Uma entrevista própria, um documento obtido pela reportagem, uma análise de dados ou uma explicação especializada podem mudar o valor daquela página para o leitor.
O próprio caso do Daily Mail ilustra essa diferença. Informar apenas que o veículo bloqueou um bot oferece uma visão parcial. Recuperar a cronologia, mostrar a abertura à negociação e relacionar o investimento na ProRata permite compreender melhor a decisão empresarial.
Para mim, esse deveria ser o objetivo editorial: produzir conhecimento que mereça ser consultado, atribuído e aprofundado.
Organic Visibility conecta esse trabalho às demais formas de descoberta da marca. O resultado precisa ser observado em reconhecimento, relacionamento, acessos e oportunidades comerciais.
Ferramentas de GEO ajudam a avaliar os efeitos dessa escolha
Depois de definir a política de acesso, a empresa precisa acompanhar como aparece nas respostas.
É nesse trabalho que entram ferramentas de Generative Engine Optimization, como a NAIA. A plataforma permite acompanhar presença da marca, respostas para perguntas monitoradas, fontes citadas e o contexto competitivo em diferentes mecanismos.
Essas informações ajudam a investigar questões que os registros de rastreamento não respondem: a marca foi mencionada? Qual página foi citada? Como a empresa foi descrita? Quais concorrentes participaram da resposta?
A estratégia de monitoramento também deve contemplar AI Overviews e AI Mode, com métodos compatíveis com cada experiência. O Search Console contribui com os dados oficiais da propriedade; a observação das respostas acrescenta contexto sobre perguntas, concorrentes e atribuição.
Como princípio de análise, eu manteria um conjunto estável de perguntas, registrando mecanismo, idioma, localização e data. Isso permite comparar períodos com menos interferência de mudanças no próprio método.
As métricas de GEO devem ser relacionadas a acessos, buscas pela marca, conversões e receita quando houver dados disponíveis. Nenhuma dessas ferramentas, isoladamente, comprova que um conteúdo participou do treinamento de um modelo.
O que eu revisaria agora?
Primeiro, o objetivo comercial. Documentaria quais conteúdos precisam de distribuição ampla, quais sustentam assinaturas e quais podem fazer parte de acordos de licenciamento.
Depois, a política por finalidade e fornecedor. Separaria rastreamento para busca, treinamento e acesso de agentes. Cada decisão precisaria ter um responsável e uma justificativa.
Na implementação, verificaria o acesso real. Conferiria Cloudflare, robots.txt, WAF e controles específicos das plataformas, preservando o histórico das alterações.
Na estratégia editorial, avaliaria identidade e diferenciação. Autoria, especialização temática e informação original precisam acompanhar a abertura técnica.
No monitoramento, compararia presença e resultado. Acompanharia indexação, tráfego, menções, fontes citadas e comportamento comercial. Uma oscilação de citações após uma mudança de configuração seria um ponto de investigação, não uma comprovação automática de causa.
Fatos, interpretação, inferência e hipótese
Fatos: os fornecedores oferecem controles diferentes para acesso, treinamento e participação em respostas. Publishers britânicos adotaram tanto bloqueios específicos quanto parcerias comerciais.
Interpretação: uma política de acesso também expressa uma estratégia de distribuição e negociação de conteúdo.
Inferência: configurações definidas sem considerar o modelo de negócio podem restringir oportunidades que a empresa desejava preservar.
Minha hipótese: permitir acesso a conteúdo público original e consistente pode ampliar oportunidades de reconhecimento da marca pelos sistemas de IA. O efeito sobre autoridade percebida, menções e citações precisa ser acompanhado e não pode ser prometido.
Conclusão
Eu partiria da abertura aos bots, especialmente quando a empresa depende de ser descoberta e reconhecida como referência. Essa escolha acompanha minha visão de que uma marca precisa participar dos ambientes em que as pessoas constroem conhecimento e tomam decisões.
Para grandes publishers, a decisão também envolve o valor econômico do acervo e da produção diária. O histórico britânico mostra que acesso aberto, bloqueios seletivos e licenciamento podem atender a objetivos diferentes, inclusive dentro de uma mesma organização.
Uma consultoria de GEO precisa avaliar como cada política de acesso afeta a descoberta do conteúdo e os objetivos do negócio. É esse o trabalho que considero essencial para uma agência de SEO especializada em GEO: orientar a decisão, verificar a implementação e acompanhar seus efeitos sobre a visibilidade e os resultados.
Minha recomendação é definir o que a empresa espera ganhar com cada forma de participação e acompanhar se isso acontece. A política de acesso deve evoluir com essa evidência, com as condições oferecidas pelas plataformas e com o valor que a presença nas IAs produz para o negócio.
Referências e créditos
- Bryan Becker, Cloudflare: Have it both ways: stay discoverable in search while disallowing AI training, 15 de setembro de 2026. Fonte das três tabelas de configuração e da imagem de interface.
- Jin-Hee Lee, Cloudflare: Bot Preference Sync, 21 de agosto de 2026, atualizado em 15 de setembro.
- Google: documentação de crawlers e Google-Extended.
- Google: controle de IA generativa na Busca.
- Fabrice Canel, Bing: controles de utilização de conteúdo no Bing Chat, 22 de setembro de 2023.
- Cloudflare: interação entre AI Crawl Control e WAF.
- OpenAI: documentação dos bots.
- Charlotte Tobitt, Press Gazette: levantamento sobre bloqueios de bots por publishers, 3 de outubro de 2023, atualizado em 10 de outubro.
- Adam Tinworth, One Man & His Blog: declarações de Rich Caccappolo sobre a estratégia da DMG Media, setembro de 2024.
- DMG Media: investimento e parceria com a ProRata, 20 de novembro de 2024.
- Gretel Kahn, Reuters Institute: reflexões do Future of Media Technology Conference, 11 de setembro de 2026.
- OpenAI e Financial Times: anúncio da parceria, 29 de abril de 2024.
- Guardian Media Group, 14/02/2025.
- Matt G. Southern, Search Engine Journal: cobertura dos controles da Cloudflare, 15 de setembro de 2026.
- NAIA: plataforma de monitoramento de visibilidade em IA.
Sobre o autor
Felipe Bazon
Felipe Bazon é CSO da Hedgehog Digital e um dos profissionais de SEO mais renomados do país com reconhecimento internacional. Em 2015 e 2020 foi eleito profissional do ano de SEO no Brasil. Além da vasta experiência operacional, é também orador regular em eventos como E-show, OME Expo, Des-Madrid, Digitalks, RD Summit e Brighton SEO.
Comentários: